
Exploiter la documentation existante
Comment des archives deviennent un socle de données étayé
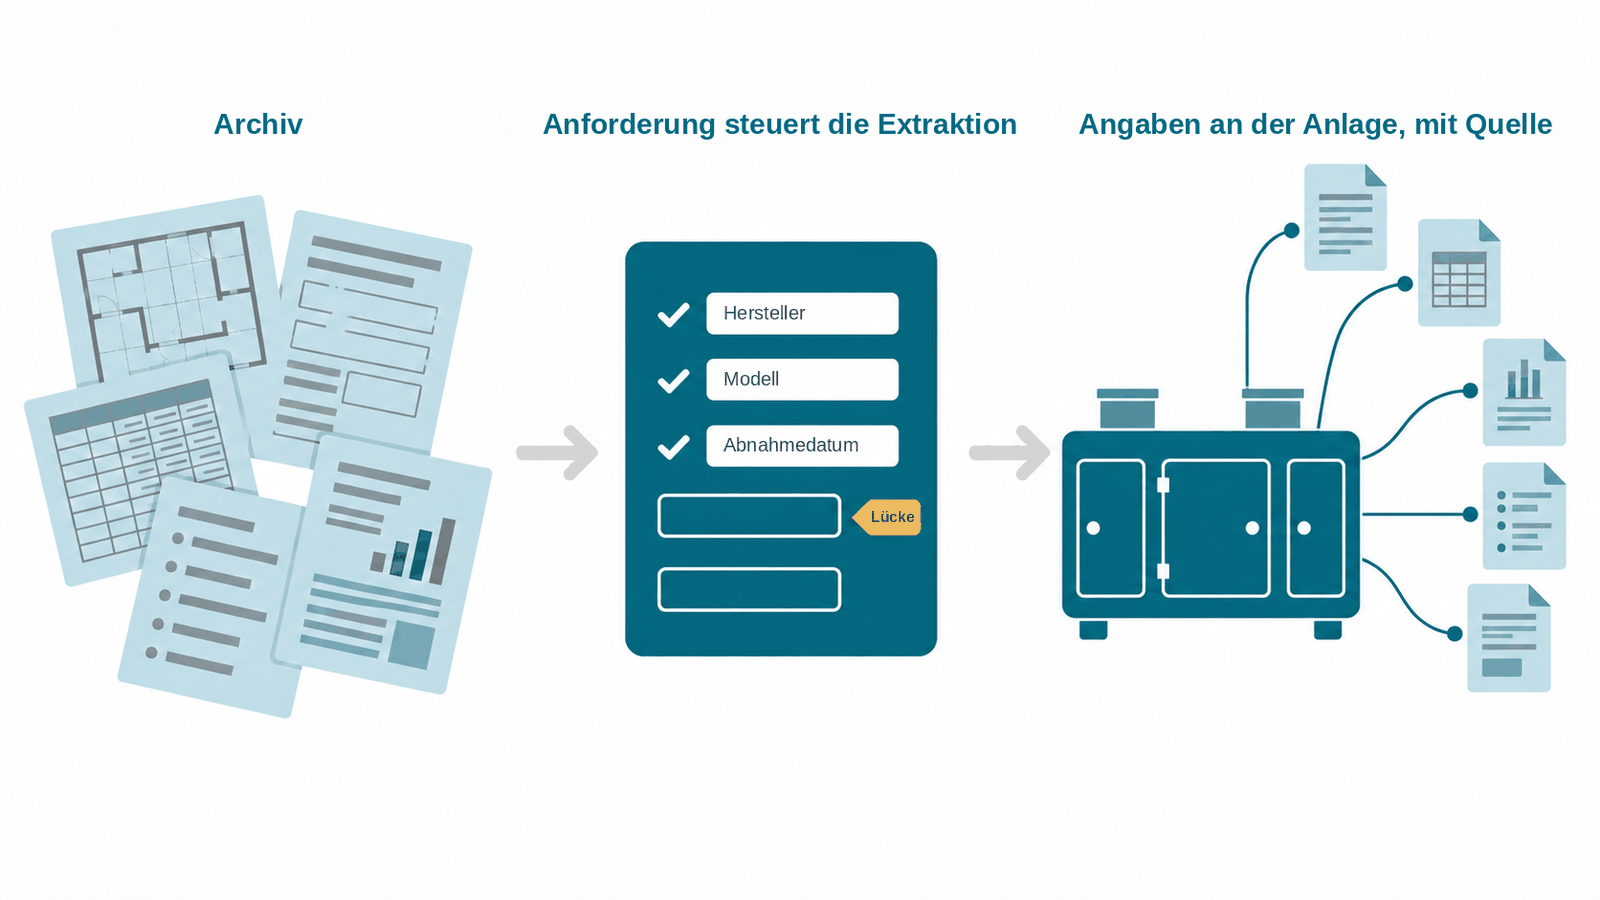
De l’exigence à l’installation en passant par l’extraction. Chaque donnée renvoie à sa source, chaque lacune reste visible.
En bref. Exploiter la documentation existante signifie extraire des documents disponibles d’un bien immobilier les données de chaque installation et les relier à leur source. L’exigence d’information, c’est-à-dire la liste des données dont l’exploitation a besoin pour chaque installation, détermine ce que l’IA recherche dans chaque document, et chaque valeur trouvée renvoie au document d’origine. Ce qui n’est pas étayé reste visible comme lacune et n’est pas deviné.
Pour un bien immobilier en exploitation depuis vingt ans, plusieurs centaines de documents existent facilement. Dans un projet, il y en avait plus de 900 pour un seul bien. Plans, procès-verbaux de réception, contrats de maintenance, rapports de contrôle, fiches techniques, schémas. Ils proviennent de différentes entreprises, de différentes transformations et de différents classements. Qui veut savoir aujourd’hui quand la ventilation du sous-sol a été réceptionnée et quel intervalle de maintenance s’applique doit chercher. Parfois il trouve la réponse, parfois deux réponses différentes, parfois aucune.
Cet article décrit comment de telles archives deviennent un socle de données auquel on peut se fier. La réponse courte : l’exigence définit les données nécessaires pour chaque installation et pilote ainsi ce qui est recherché dans les archives. Chaque donnée trouvée renvoie à la source dans le document d’origine, chaque donnée manquante reste visible comme lacune.
Un classement de documents plutôt que l’information au niveau de l’installation
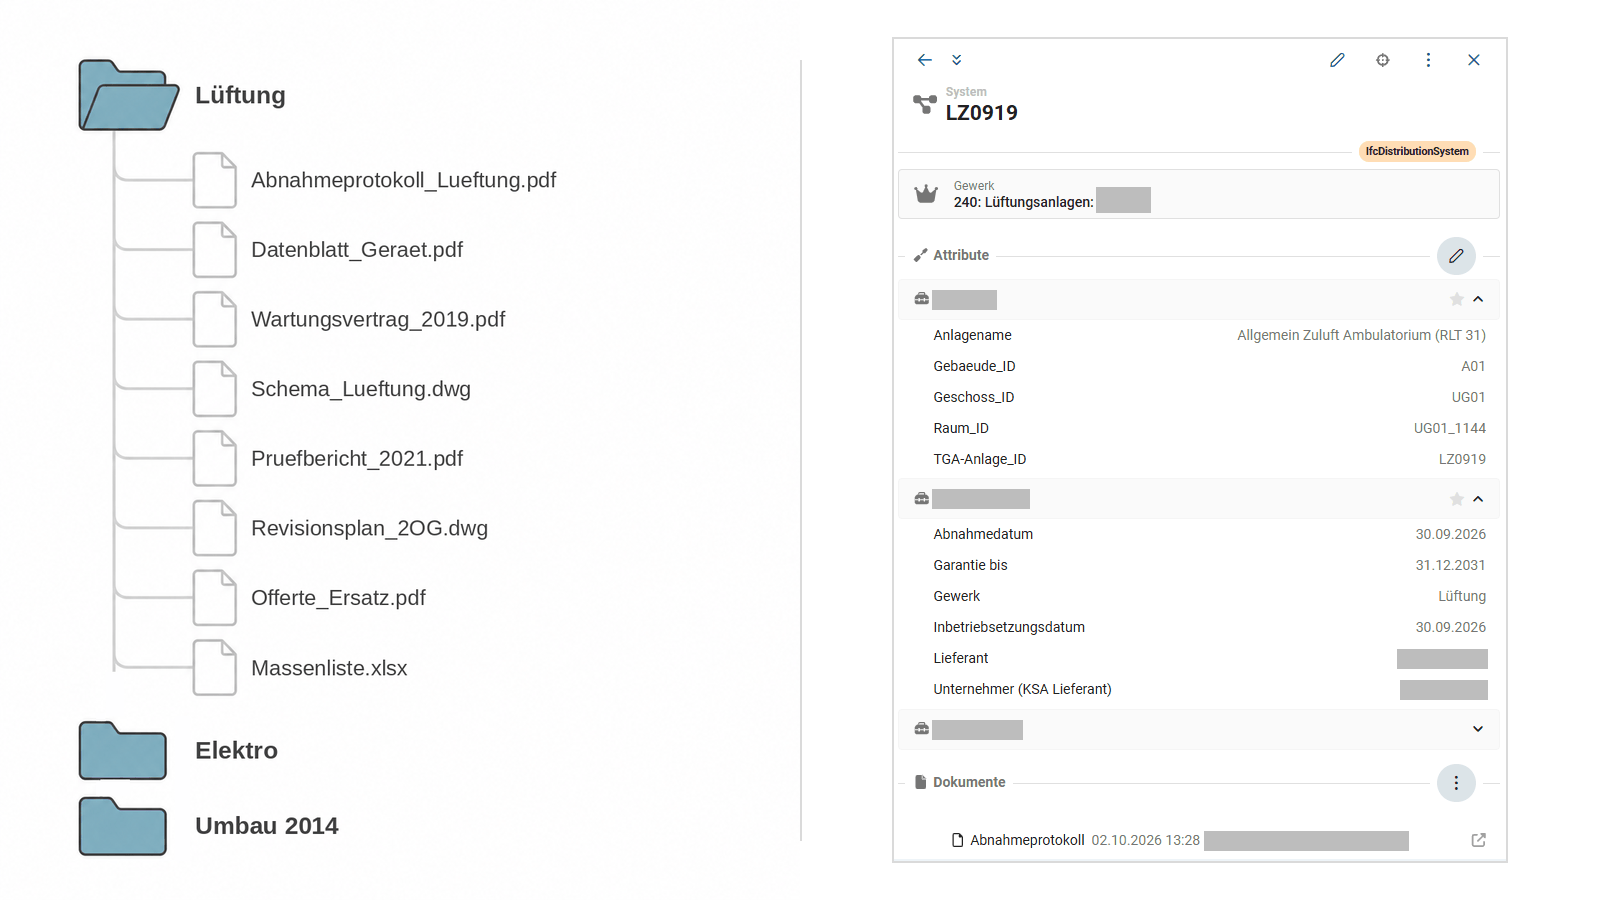
La plupart des classements dans l’exploitation des bâtiments sont organisés par documents. Un dossier pour la ventilation, un dossier pour les installations électriques, un dossier pour la transformation de 2014. C’est pratique pour la remise, mais pas pour l’exploitation. Car en exploitation, personne ne demande : « Quels documents existe-t-il sur la ventilation ? ». La question est : « Quel modèle est installé, qui l’a installé, quand a-t-il été réceptionné, et la garantie court-elle encore ? ».
Ces données figurent dans les documents, mais nulle part comme information sécurisée au niveau de l’installation. Le fichier existe, l’information non. C’est précisément cet écart entre classement et information qui explique pourquoi tant d’archives semblent complètes et n’aident pourtant pas au quotidien.
Pourquoi les échantillons ne suffisent pas
Face à de grandes archives, on procède habituellement par échantillon. On contrôle quelques installations, on constate que les documents sont à peu près corrects, et on en conclut ce qu’il en est du reste. C’est compréhensible, car un contrôle exhaustif à la main n’est pas finançable. Mais c’est aussi la raison pour laquelle les erreurs ne se remarquent que lorsqu’une installation tombe en panne ou qu’un audit approche.
Avec l’appui de l’IA, cela change. On ne lit plus une sélection de documents, mais chacun d’eux. Et on ne vérifie pas si un fichier existe, mais si l’affirmation requise y est étayée. Contrôle exhaustif au lieu d’échantillon, contenu au lieu de l’existence d’un fichier. Voilà la vraie différence, pas la rapidité.
Le déroulement en trois étapes
Première étape : l’exigence. Avant qu’un seul document soit lu, on définit quelles données sont nécessaires pour chaque type d’installation. Pour une installation de ventilation, ce sont par exemple le fabricant, le modèle, la date de montage, la date de réception, l’intervalle de maintenance et l’entreprise responsable, ainsi que les documents qui étayent ces données. Cette exigence pilote la recherche. Ce n’est pas l’archive qui détermine ce qui est trouvé, mais le besoin de l’exploitation.
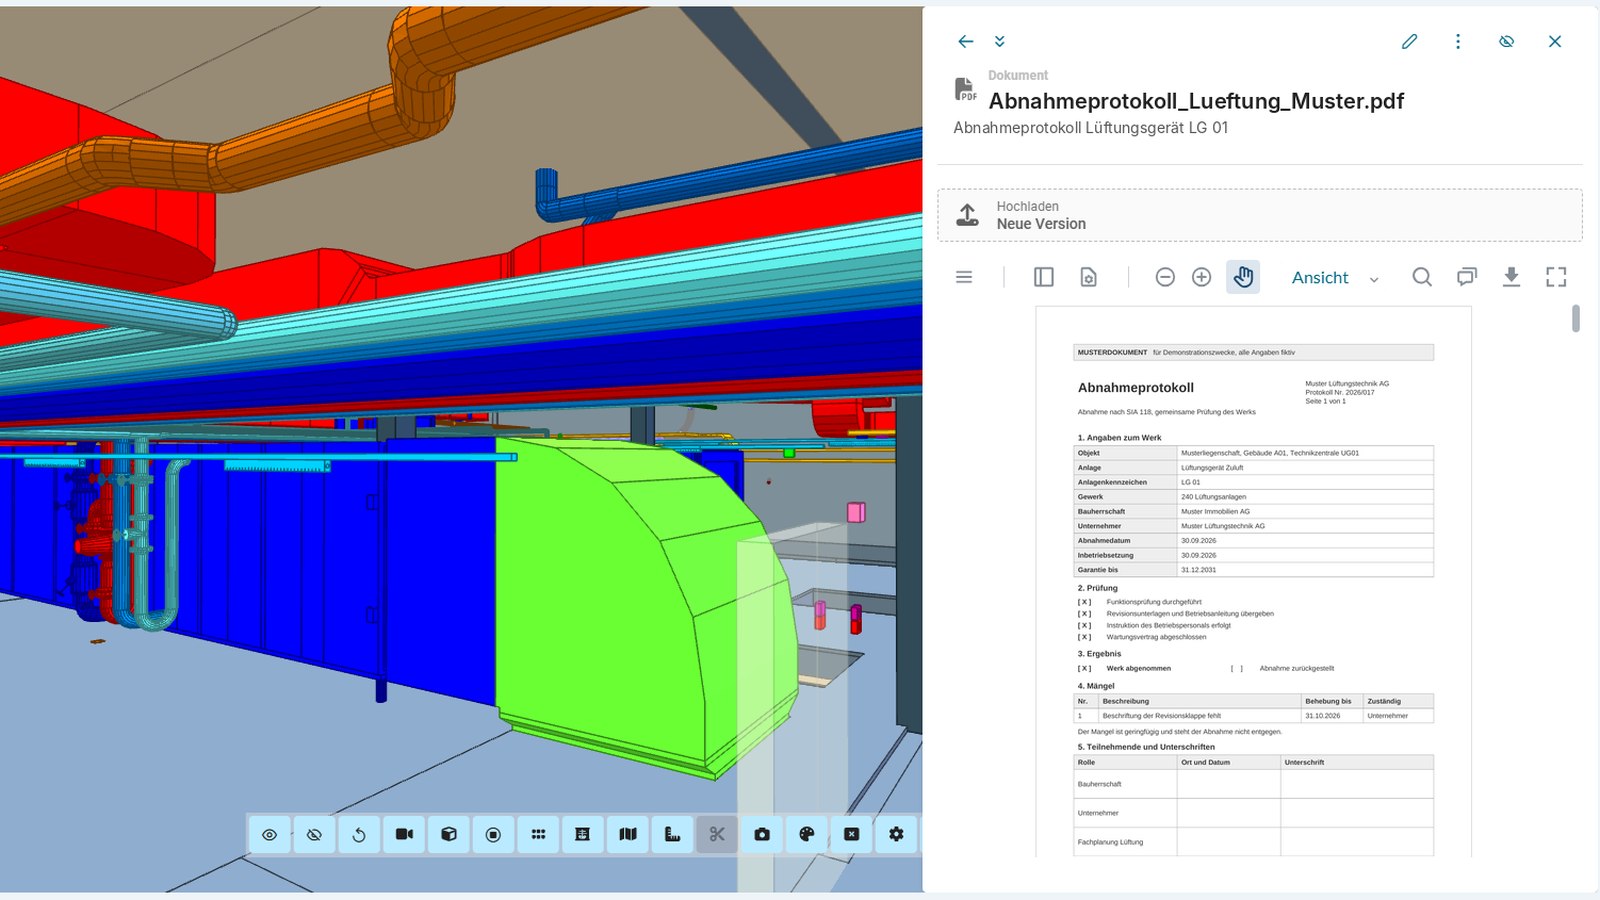
Deuxième étape : l’extraction à partir de sources productives. Tous les documents n’ont pas la même valeur. Un procès-verbal de réception selon la norme SIA 118 indique l’installation, la date, l’entreprise et les défauts sur une page. Une fiche technique indique le fabricant et le modèle. L’extraction se concentre sur de telles sources, y reconnaît tableaux, titres et sections, et en extrait les valeurs requises.
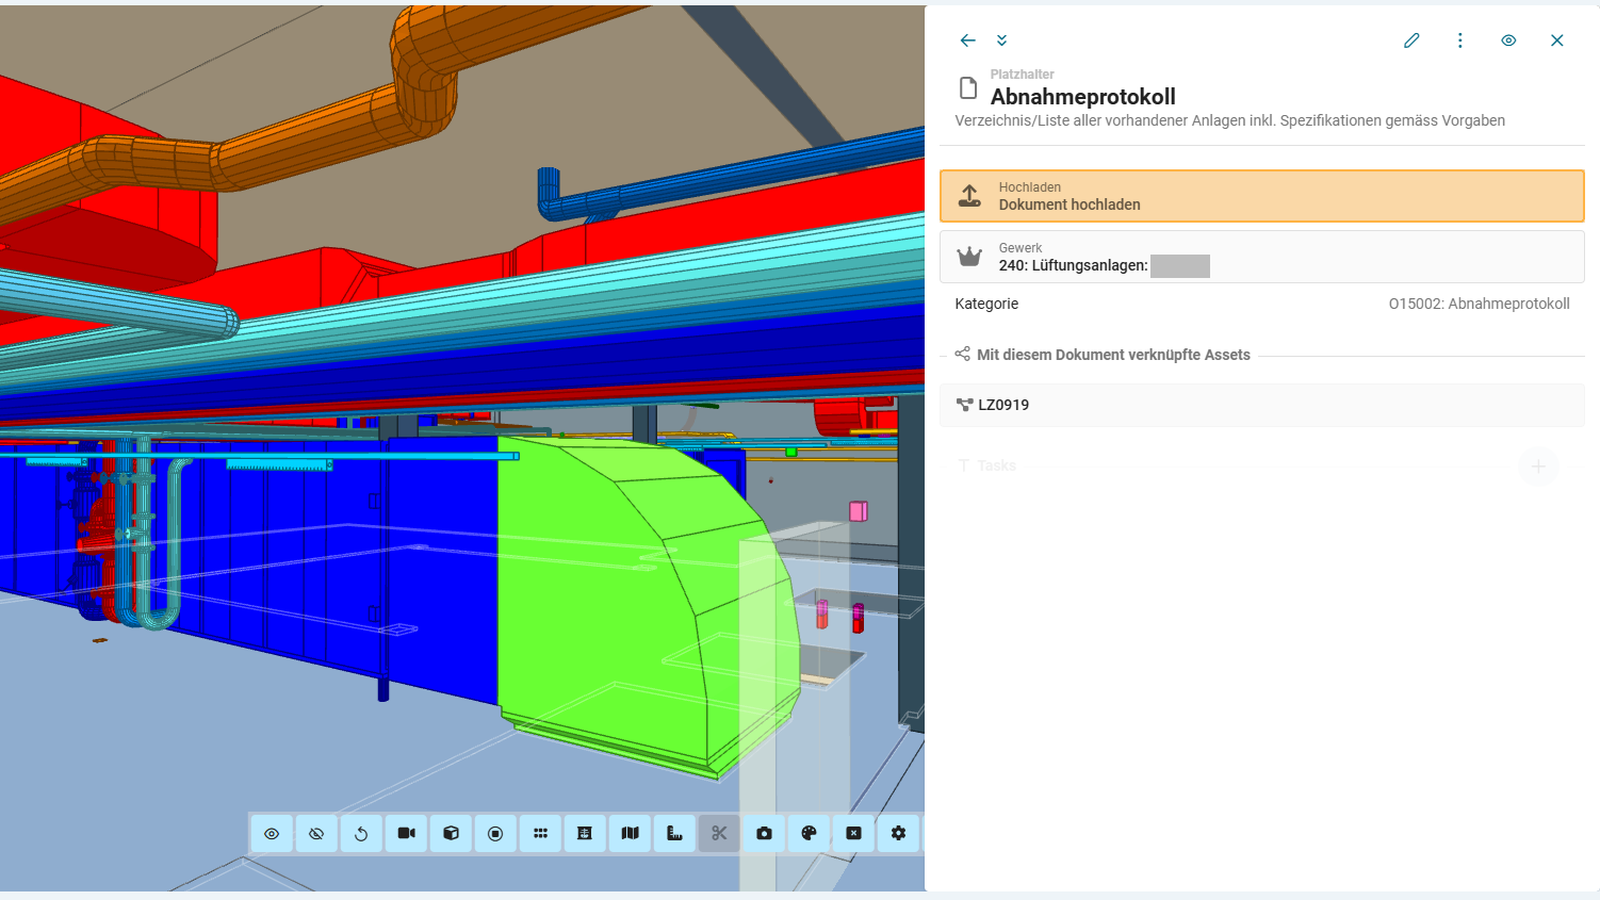
Troisième étape : le rattachement à l’installation. Chaque valeur trouvée est rattachée à l’installation à laquelle elle appartient et reliée à la source dans le document d’origine. Du dossier « Ventilation » naît ainsi un jeu de données par installation, avec les données, les documents associés et l’indication de la provenance de chaque donnée. L’installation est en outre localisée par bâtiment, étage et local, de sorte que le jeu de données est facile à retrouver au quotidien.
Rendre les lacunes visibles plutôt que deviner
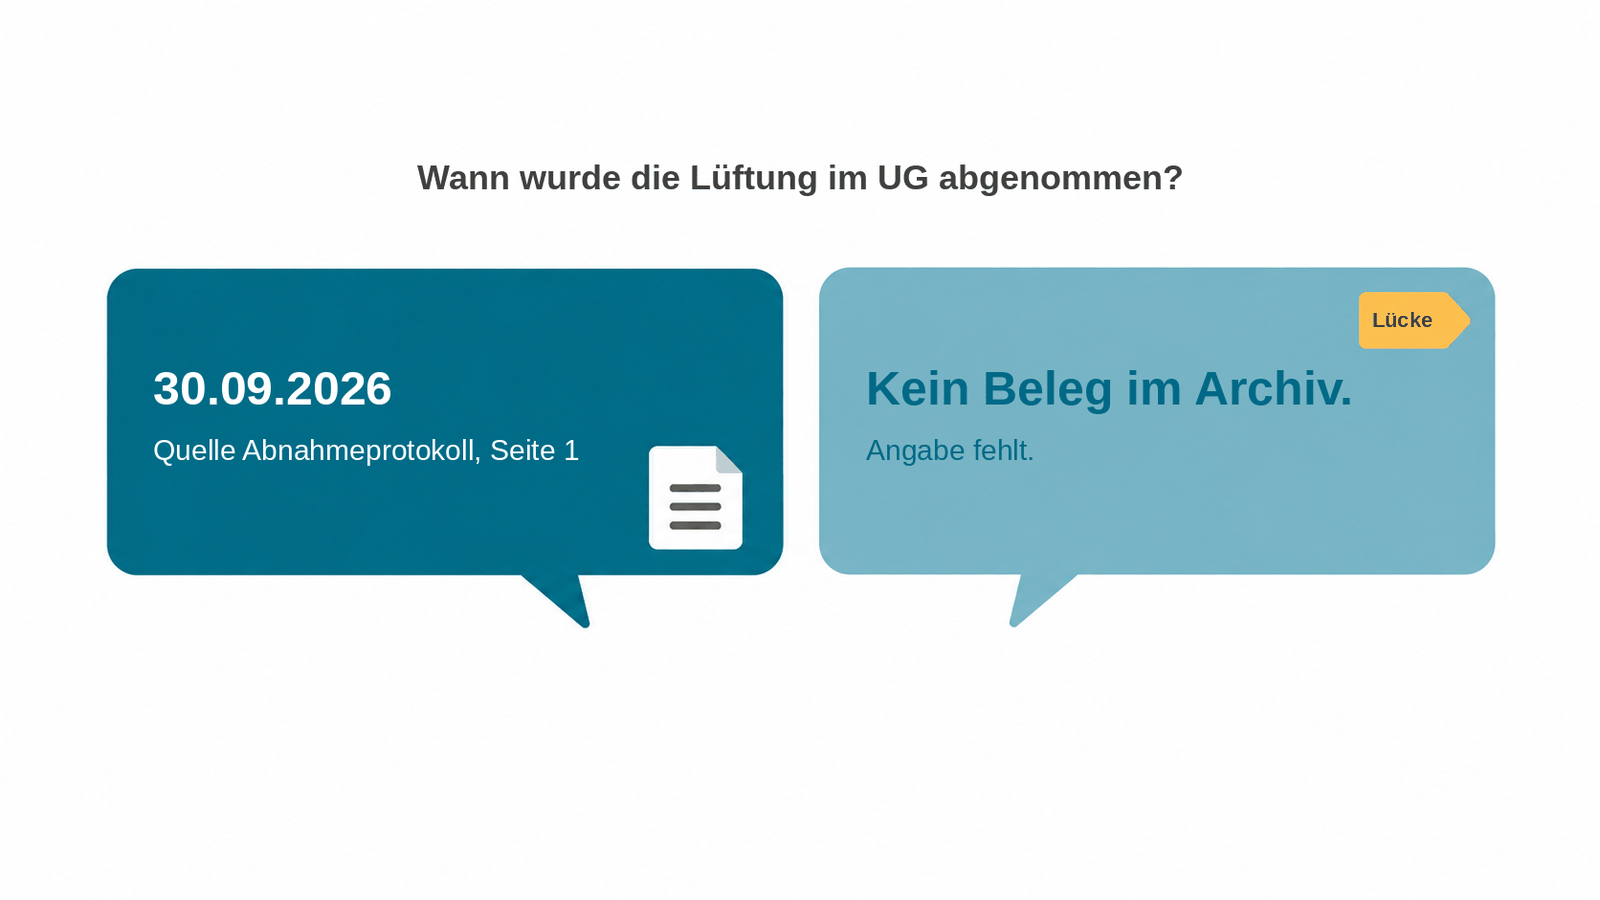
Le principe le plus important est simple. Là où aucun justificatif n’est trouvé dans les archives, la valeur reste vide et est signalée comme lacune. Rien n’est estimé, rien n’est repris d’un cas similaire et rien n’est inventé.
Cela semble évident, mais ça ne l’est pas. Un modèle de langage lâché sur des archives sans cette règle fournit une réponse fluide à chaque question, même là où il n’y a aucun fondement. Pour l’exploitation, une donnée inventée est pire qu’une donnée manquante, car elle mine la confiance dans l’ensemble du socle de données. Une lacune visible, en revanche, est une tâche à accomplir. Elle peut être comblée de manière ciblée, auprès de l’entreprise, du fabricant ou sur place.
À l’issue de l’exploitation documentaire, on dispose donc non seulement d’un socle de données, mais aussi d’une liste de ce qui manque, triée par installation et par importance.
Ce que cela rend possible
Dès que les données sont rattachées aux installations et étayées, le travail avec les archives change. Une question sur le bâtiment peut être posée en langage naturel. La réponse indique le passage source et mène d’un clic à l’endroit du document. Si le justificatif manque, le système le dit au lieu de faire une supposition.
Le même socle de données porte aussi les questions plus vastes. Pour un reporting de durabilité, on peut établir quelles installations de quelle année de construction se trouvent dans quels bâtiments. Pour un programme d’assainissement, on peut montrer où la documentation est complète et où elle ne l’est pas. Pour une remise à un autre système, les données sont disponibles de manière structurée et avec leur source, au lieu d’un dossier de fichiers.
Par où commencer
Le démarrage ne nécessite pas de grand projet. Un objet et un lot type de documents, tel qu’il existe de toute façon pour un bien immobilier, suffisent. Il en résulte trois éléments que l’on peut évaluer : un socle de données exploité pour cet objet, une liste des lacunes et le retour d’expérience sur les types de documents productifs dans ses propres archives, et ceux qui ne le sont pas.
Avec ce savoir, on peut décider si et comment le reste du portefeuille suit. Les archives restent ce qu’elles sont. Elles deviennent simplement lisibles.
Questions fréquentes
Que signifie exploiter la documentation existante ?
Les documents disponibles d’un bien immobilier sont lus, les données de chaque installation en sont extraites, rattachées à l’installation et reliées à leur source dans le document d’origine. D’un classement de fichiers naît un socle de données aux informations étayées.
Quels documents sont les plus précieux pour cela ?
Les procès-verbaux de réception, les fiches techniques, les contrats de maintenance et les rapports de contrôle. Ils indiquent l’installation, le fabricant, le modèle, la date et la responsabilité en quelques pages, et sont donc plus productifs que les plans ou la correspondance générale.
Que deviennent les données qui ne figurent dans aucun document ?
Elles restent vides et sont signalées comme lacune. Aucune valeur n’est estimée ni reprise d’un cas similaire. La liste des lacunes montre ce qui reste à obtenir auprès de l’entreprise, du fabricant ou sur place.
En quoi cela diffère-t-il d’un chatbot placé sur les archives ?
Un chatbot placé sur l’ensemble des archives répond à chaque question, même sans fondement. Dans l’exploitation documentaire, les données sont rattachées à l’installation avec leur justificatif. Chaque réponse indique le passage source et mène d’un clic à l’endroit du document. Si le justificatif manque, cela est dit.
Quel est l’effort pour le propriétaire ?
Pour démarrer, un objet et les documents déjà disponibles suffisent, remis sous forme de paquet, par exemple une arborescence de dossiers. L’exigence est fixée avant l’import, l’exploitation documentaire se déroule ensuite automatiquement.
Intéressé par LIBAL pour votre projet ?
Planifiez votre démo personnalisée, nous nous réjouissons de cet échange.